Tsundoku
Un blog de lecture tenu de la première intention graphique jusqu’au serveur en production.
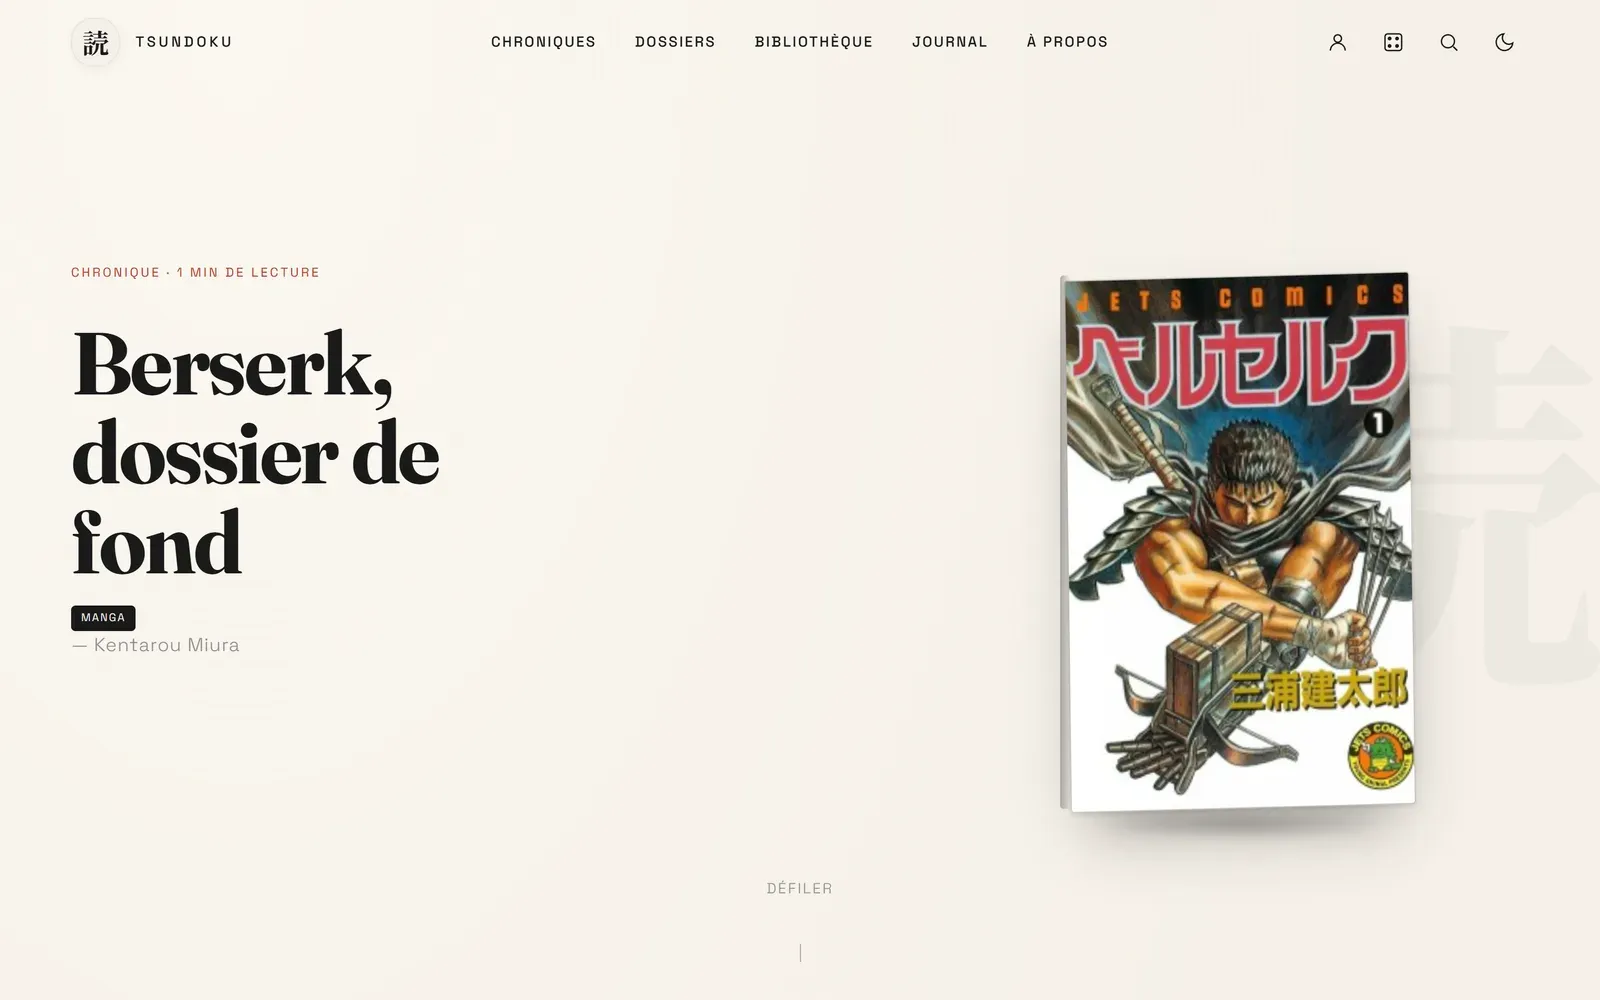
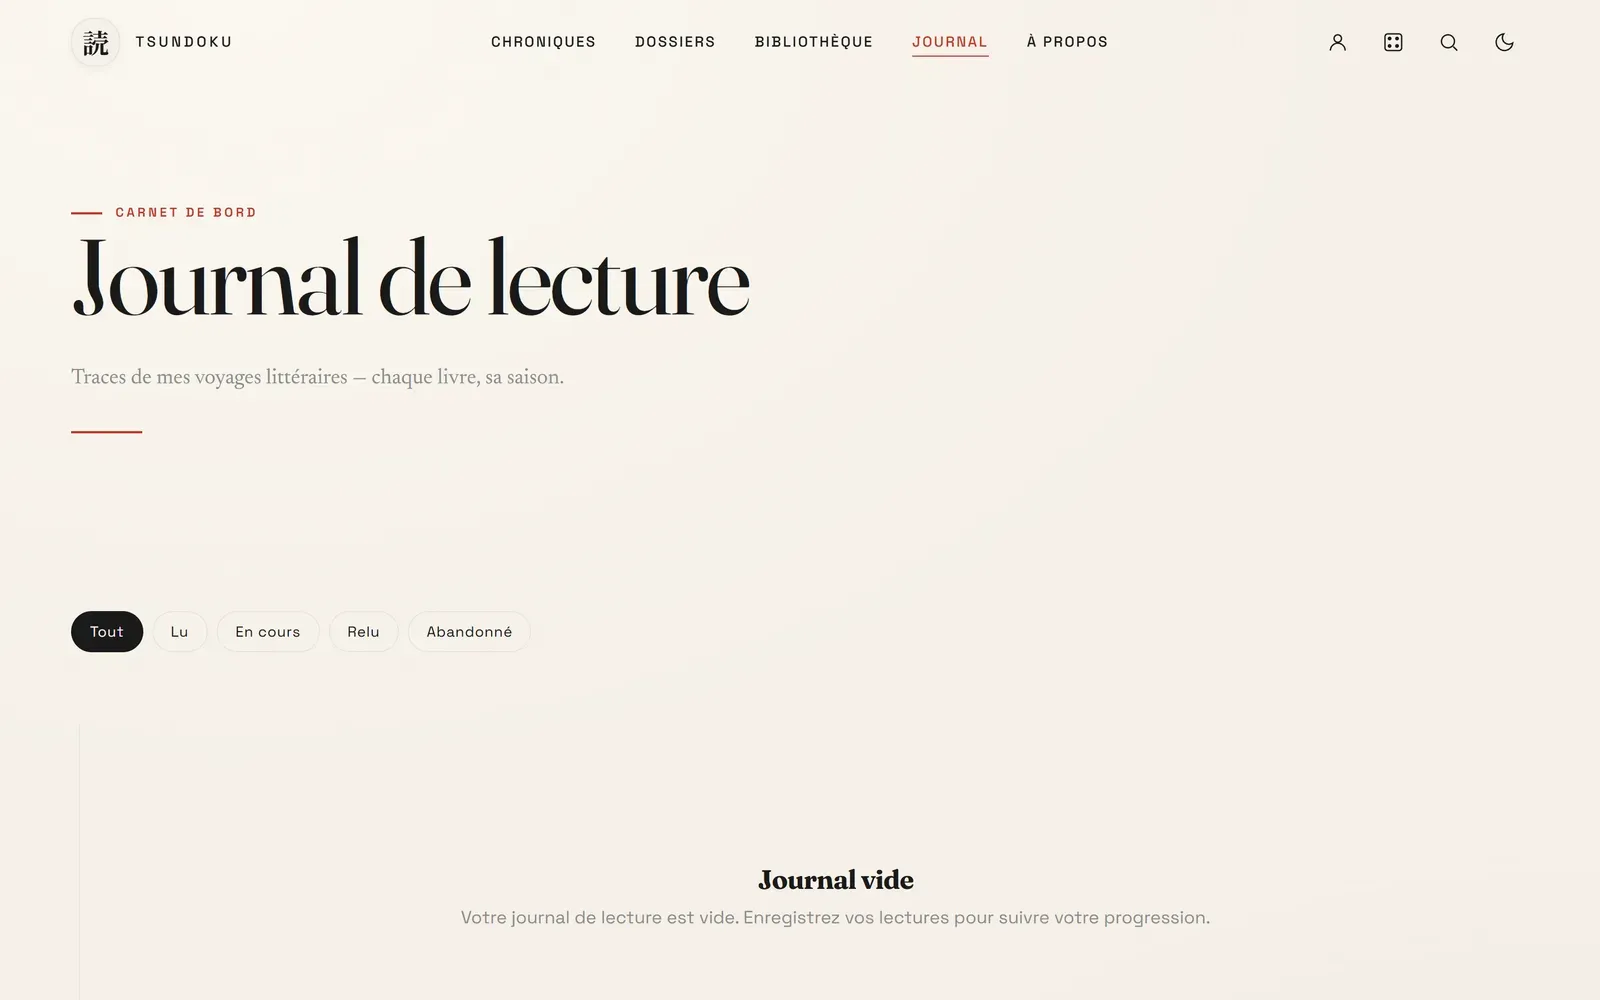
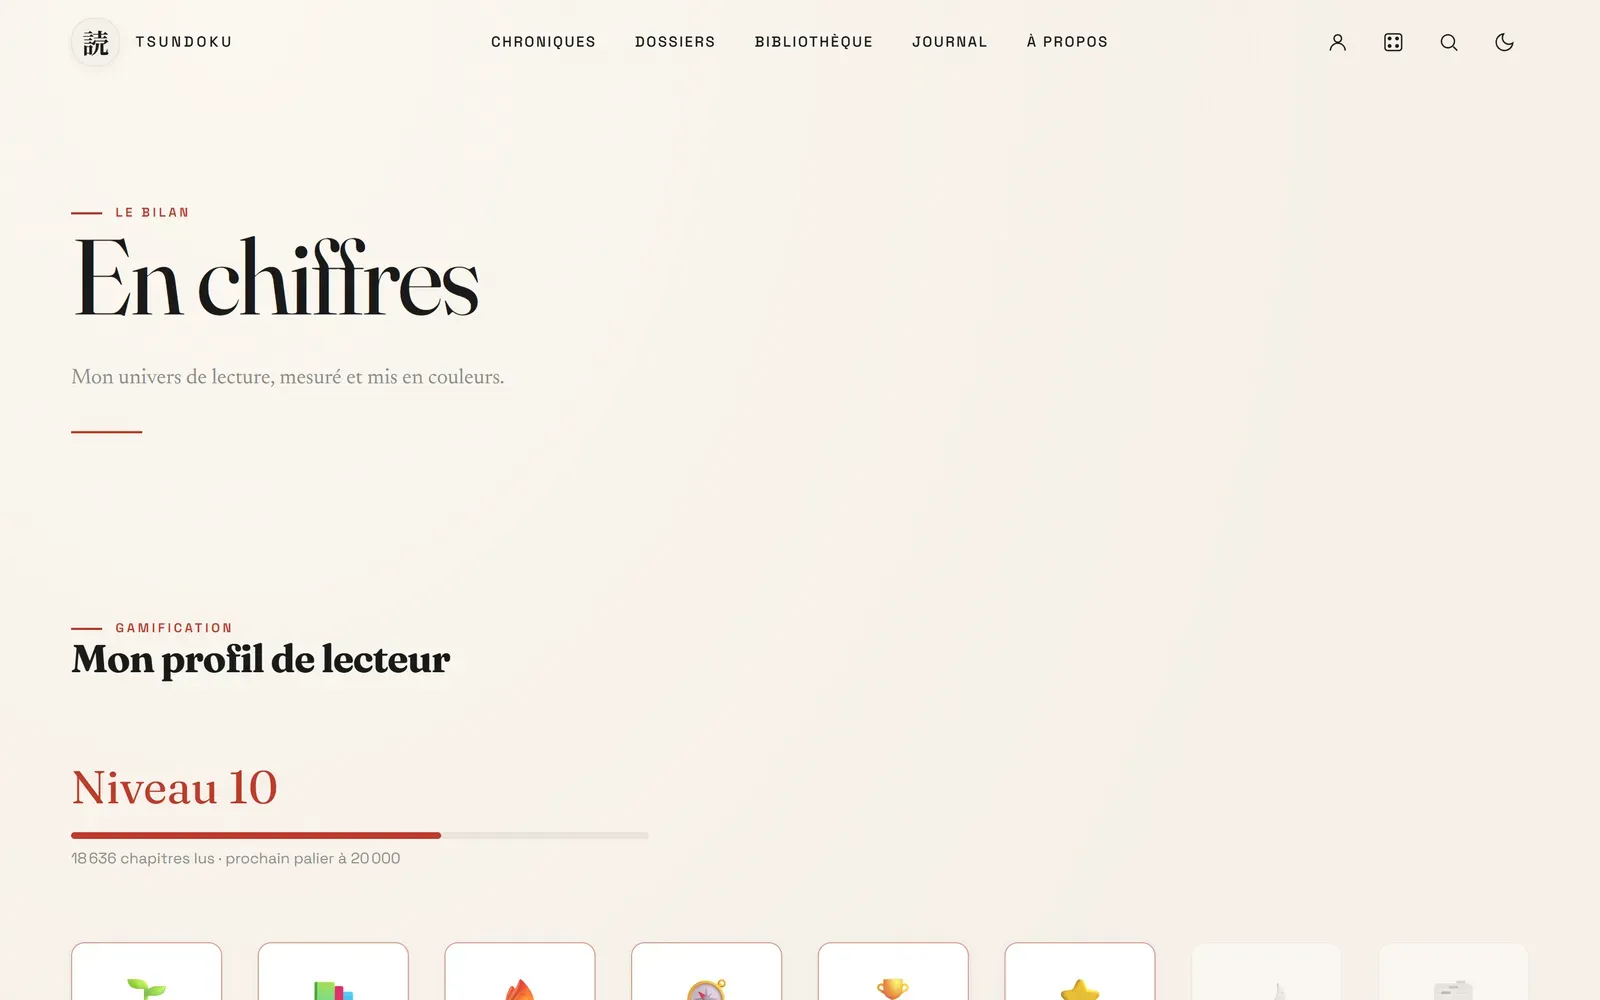
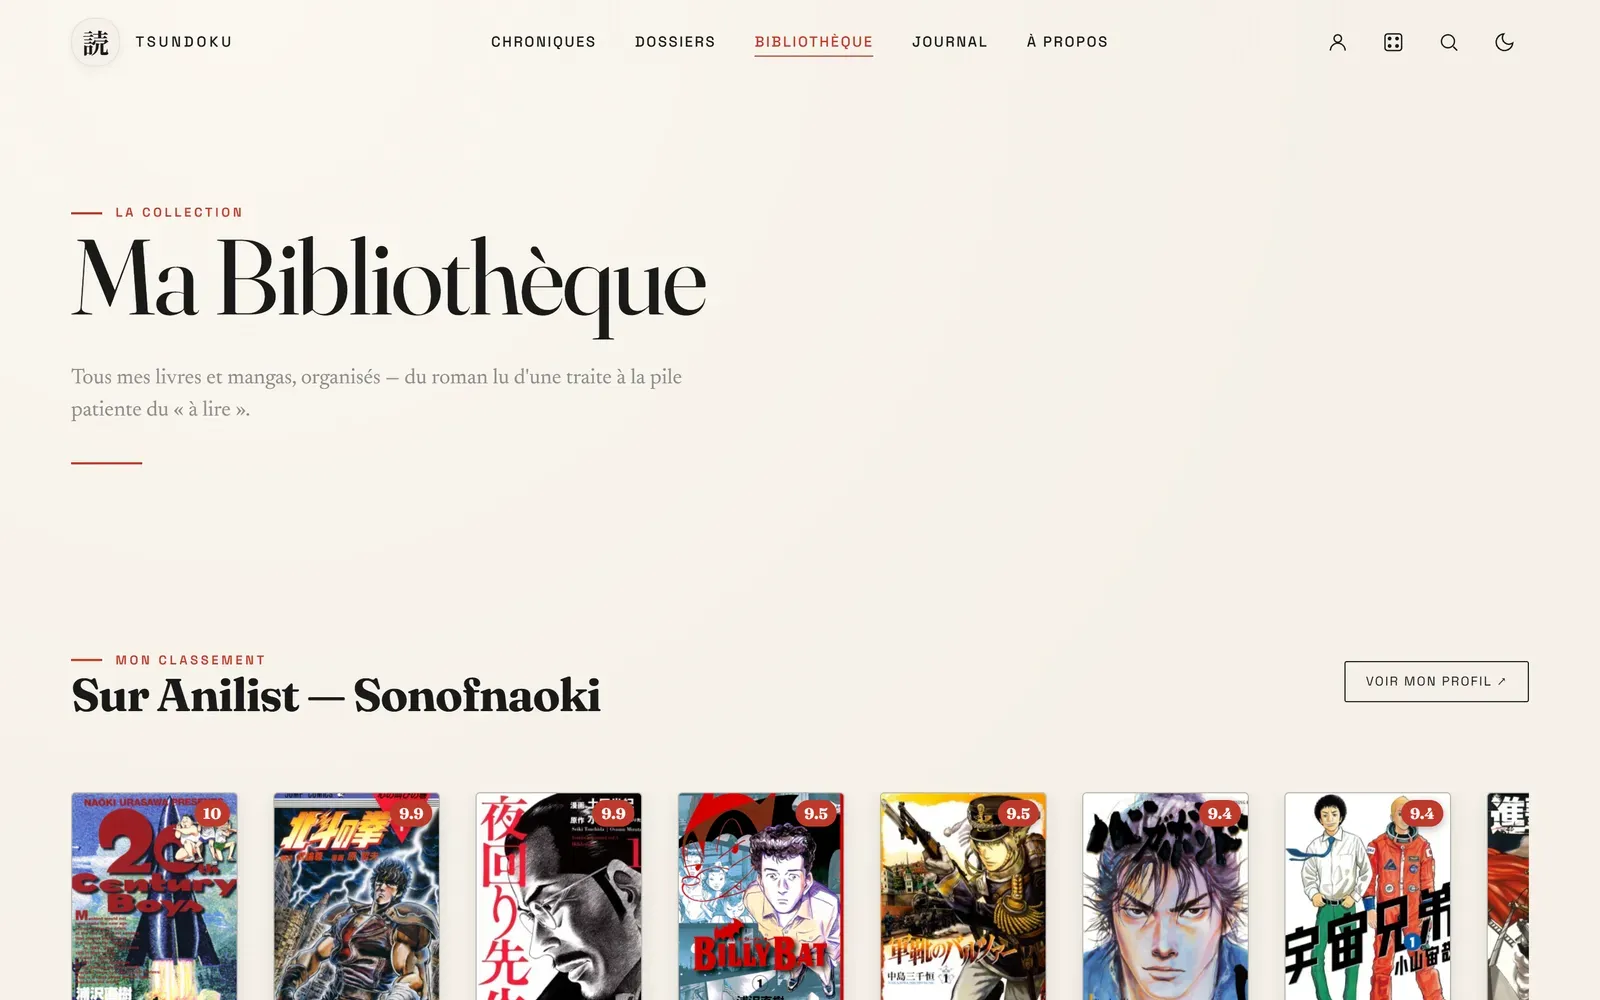
Plateforme de chroniques manga complète : rédaction riche, import .docx/.pdf reformaté automatiquement aux codes du site, métadonnées réelles via Anilist, SEO rendu côté serveur, lecture audio par voix neuronale. Menée de la direction artistique jusqu’à la mise en ligne.
Le point de départ
Je voulais un blog de lecture qui ne ressemble à aucun autre : un objet éditorial avec une direction artistique japonaise assumée, faite d’espace (ma 間), de la beauté de l’imparfait (wabi-sabi 侘寂), d’un papier washi off-white et d’un vermillon utilisé avec parcimonie.
Le pari : une expérience aussi soignée qu’un site primé, posée sur un vrai produit avec comptes, rédaction, SEO et mise en production.
Je ne voulais pas « un blog ». Je voulais tenir un produit de la première intention graphique jusqu’au serveur en ligne.
L’import qui se reformate tout seul
Le cœur difficile : déposer un .docx ou un .pdf et le voir instantanément remis aux polices, couleurs et grille du site, sans retouche.
Un pipeline d’ingestion extrait le contenu (mammoth pour le .docx, pdf.js pour le .pdf, plus .md, .html et .txt), le normalise en un arbre de blocs, puis réapplique les design tokens. Le texte d’un auteur entre tel quel et ressort dans l’identité de Tsundoku.
Un SEO qui ne dépend pas du JavaScript
Une SPA rend ses balises trop tard pour les robots. Les meta sont donc générées côté serveur, page par page : title, description, canonical, Open Graph et JSON-LD au moment de la requête.
S’y ajoutent un flux RSS, un sitemap (articles et séries), un robots.txt et une image Open Graph par défaut : le site se partage et se référence comme un média.
Architecture
- Express + MySQL (mysql2), schéma normalisé en 3NF
- Auth JWT double jeton, bcrypt, validation Joi, Helmet, CORS, rate-limit, logs Winston
- Pipeline d’import .docx / .pdf / .md / .html → blocs normalisés → tokens du site
- SEO serveur : meta, OG, JSON-LD, RSS, sitemap, robots
- Étagère 3D Three.js, Lenis, GSAP ScrollTrigger, statistiques Chart.js
La production, là où on apprend vraiment
Tsundoku tourne sur Render (serveur) et Aiven (MySQL managé), sur des offres gratuites. Le serveur sert l’API et le front sur un seul port.
Les pièges de prod m’ont appris autant que le code : cold-start du free tier (keep-alive), CORS entre domaines, migration d’une base locale vers une base distante. Déboguer sans le confort du localhost est une compétence à part entière.
En images